Что такое генерация видео по тексту
Режим text-to-video превращает описание в клип без исходного изображения. Вы пишете, что происходит, модель собирает кадры, движение и свет.
Это самый доступный вход в генерацию: не нужны ни фото товара, ни раскадровка. И самый обманчивый, потому что управлять словами сложнее, чем картинкой.
Разница видна на первом же тесте. Одно и то же описание даёт разные дубли, и предсказуемость появляется только после того, как вы разложили текст на управляемые части.
Что модель берёт из описания
Модель разбирает текст на сущности и отношения: кто в кадре, что делает, где, в каком свете, какая камера. Дальше она достраивает детали из обучения.
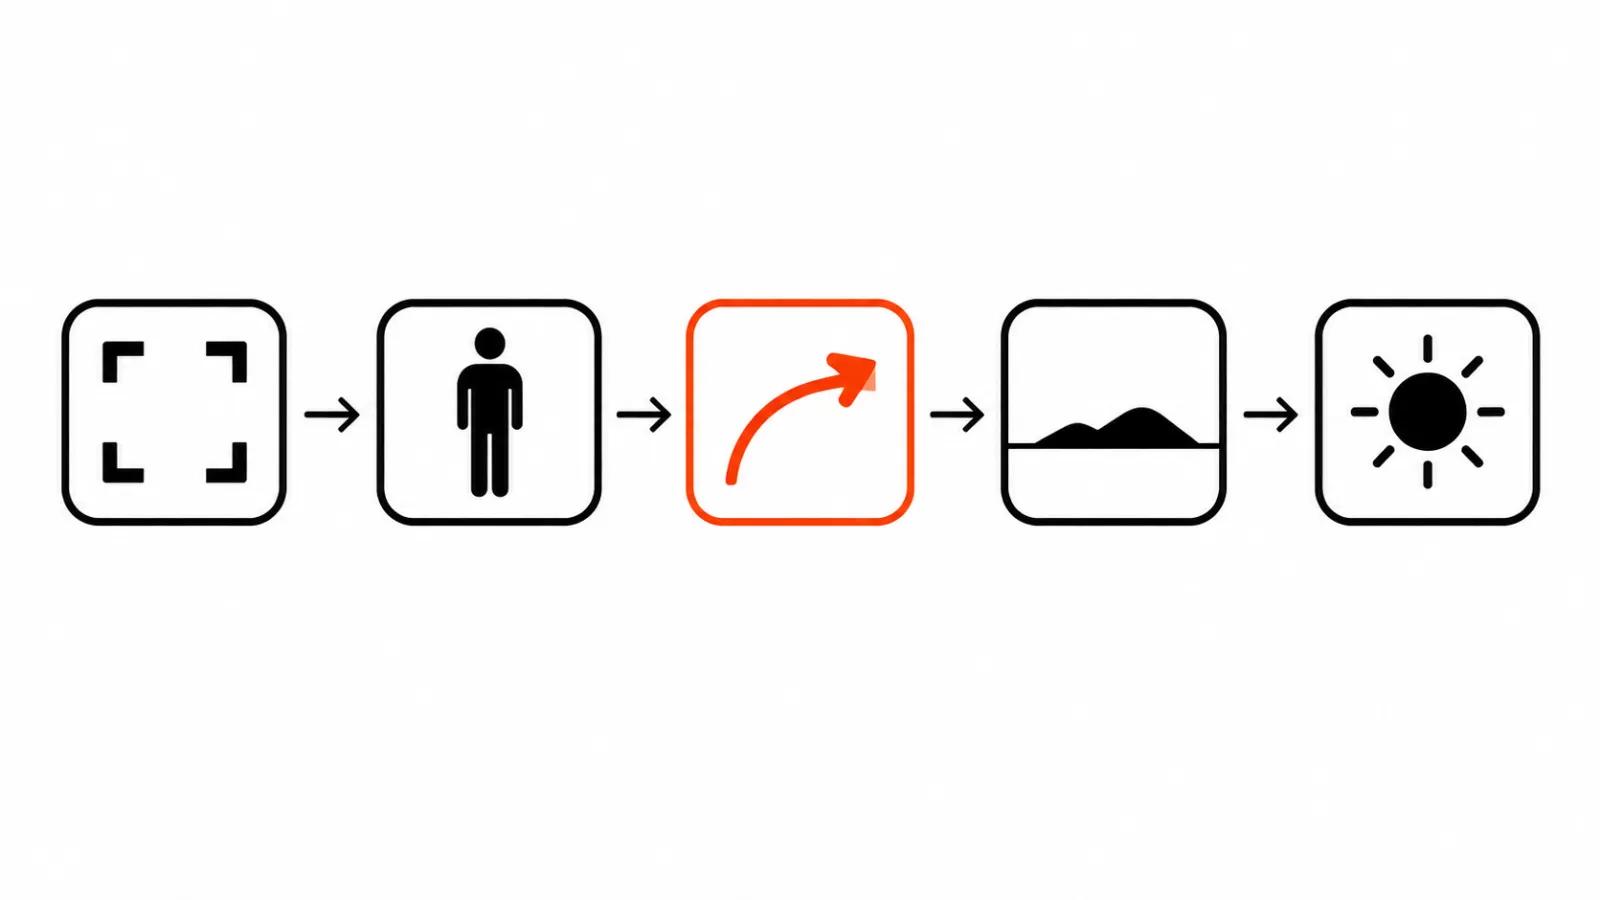
Мой рабочий каркас описания состоит из пяти элементов: тип кадра, субъект, действие, место и свет. Пример: широкий кадр ребёнка с красным воздушным змеем в парке, золотой час, камера медленно поднимается. Всё, что не названо, модель заполнит сама, и заполнит типично. Отсюда берутся одинаковые лица, одинаковая погода и странные руки.
Текст против картинки: где режим сильнее
Режим из текста выигрывает в трёх случаях.
Когда сцены ещё нет физически: нужно увидеть настроение, свет, движение камеры до того, как строить декорации.
Когда важна вариативность: десять разных трактовок одной идеи дешевле десяти эскизов художника.
Когда продукт не нужно показывать точно: атмосфера, фон, абстракция, переход.
Режим из картинки выигрывает в остальном. Если товар должен остаться собой, нужен референс: фото упаковки, кадр из съёмки, сгенерированный по референсу персонаж. Текст не удержит форму банки и логотип.
Практическое правило: текст задаёт сцену, картинка задаёт объект. В одном проекте их обычно комбинируют.
Длина и лимиты: что говорят документы
Ограничения у всех разные, и их стоит знать до раскадровки.
Kling 3.0 в режиме text-to-video принимает настройки разрешения, соотношения сторон, длительности, звука и мультишотов. В примере из документации стоят разрешение 4K, соотношение 16:9, длительность 15 секунд и включённый мультишот.
Kling 4.0, по описанию самой платформы, генерирует до 30 секунд за один запуск, поддерживает до десяти ключевых кадров и до пятнадцати референсов.
Runway считает расход по кредитам: на странице тарифов сказано, что Gen-4.5 тратит 12 кредитов на секунду видео. Значит, длинный план экономичнее собирать из коротких запусков, которые проще отобрать.
Google в документации Gemini API сообщает, что предпросмотр Veo 3.1 в этом API закрыт, а для генерации видео предлагается Gemini Omni Flash, который работает с текстом, изображениями, аудио и видео и поддерживает многоходовое редактирование.
Вывод для планирования простой: длинный кадр получают склейкой коротких. Даже там, где модель обещает тридцать секунд, сцена из пяти планов надёжнее собирается из пяти запусков.
Как писать описание
Пять элементов, которые стоит назвать всегда: тип кадра, субъект, действие, место, свет. Дальше добавляют оптику и движение камеры, если они важны.
Порядок слов имеет значение. Первое предложение задаёт сцену, второе уточняет движение, третье фиксирует стиль. Если стиль поставить в начало, модель может подчинить ему всё остальное.
Пишите конкретно. «Женщина в светлой рубашке ставит чашку на стол у окна, утренний свет сбоку, камера неподвижна» работает лучше, чем «уютное утро с кофе».
Негативные формулировки слабые. Фраза «без текста и логотипов» часто приводит к появлению текста, потому что модель цепляется за существительное. Проще перегенерировать дубль.
Итерации: почему десять попыток это норма
Генерация почти никогда не даёт нужный кадр с первого раза. В этом нет брака, это свойство режима.
Практика такая: один запуск для проверки идеи, затем серия из пяти-десяти дублей с небольшими изменениями. Меняют по одному параметру, чтобы понимать, что повлияло на результат.
Время тоже планируют. Рендер занимает минуты, и это нормальная часть процесса, особенно когда сцен много.
Если сцена нужна к сроку, генерацию ставят в начало производства. Тогда остаётся время на пересборку.
Чек-лист перед первой генерацией
Сформулируйте задачу кадра одним предложением. Определите, что в кадре должно остаться неизменным. Решите, нужен ли референс изображения. Выберите модель под длину и разрешение. Запишите описание по пяти элементам. Сделайте один тестовый запуск. Сравните с задачей. Зафиксируйте рабочую формулировку и меняйте по одному параметру.
Отдельно проверьте права и раскрытие. Если реалистичная сцена создана генеративно и выглядит как съёмка, YouTube просит включить соответствующую настройку при загрузке. Это правило площадки, и его проще выполнить сразу.
Вывод
Генерация видео по тексту это инструмент постановки сцены. Она сильна там, где нужна идея, атмосфера и скорость, и слаба там, где нужно точное совпадение с реальным объектом.
Мой рабочий подход такой: текст для сцены, картинка для объекта, монтаж для смысла. Живые планы с людьми я оставляю камере и собираю их как ручные ролики, потому что мимика пока не воспроизводится стабильно. Если нужен поток сцен под проект, видео нейросетями закрывает окружение и эффекты, а ключевые планы с людьми остаются ручными роликами. Для серийных форматов, где важна одинаковая рамка, помогает отдельная сборка под массовые вертикальные ролики.