Три работы, которые вышли вечером 21 октября
21 октября после 15:00 UTC на arXiv появились три статьи, и все они про одно и то же: генеративное видео упирается в стоимость кадра и в объём контекста, который модель способна удержать.
Первая, CausalAlign (https://arxiv.org/abs/2610.29915), вышла в 15:54 UTC. Она про то, почему камера в сгенерированном клипе уезжает к финалу и как это лечить. Вторая, Attn-Forcing (https://arxiv.org/abs/2610.30036), в 16:59 UTC, про память при потоковой генерации, когда кадры идут непрерывно и старый контекст нельзя держать целиком. Третья, CADRE (https://kyutai.org/blog/2026-10-22-cadre/), в 17:58 UTC: команда Kyutai разбирает сжатие видео для интерактивных мировых моделей и выкладывает код, веса и живое демо.
Почему это важно: три статьи бьют в одну точку с разных сторон, и вместе они описывают, где именно сейчас проходит граница между «красиво на демо» и «работает в проде».
CausalAlign: почему камера плывёт к концу клипа
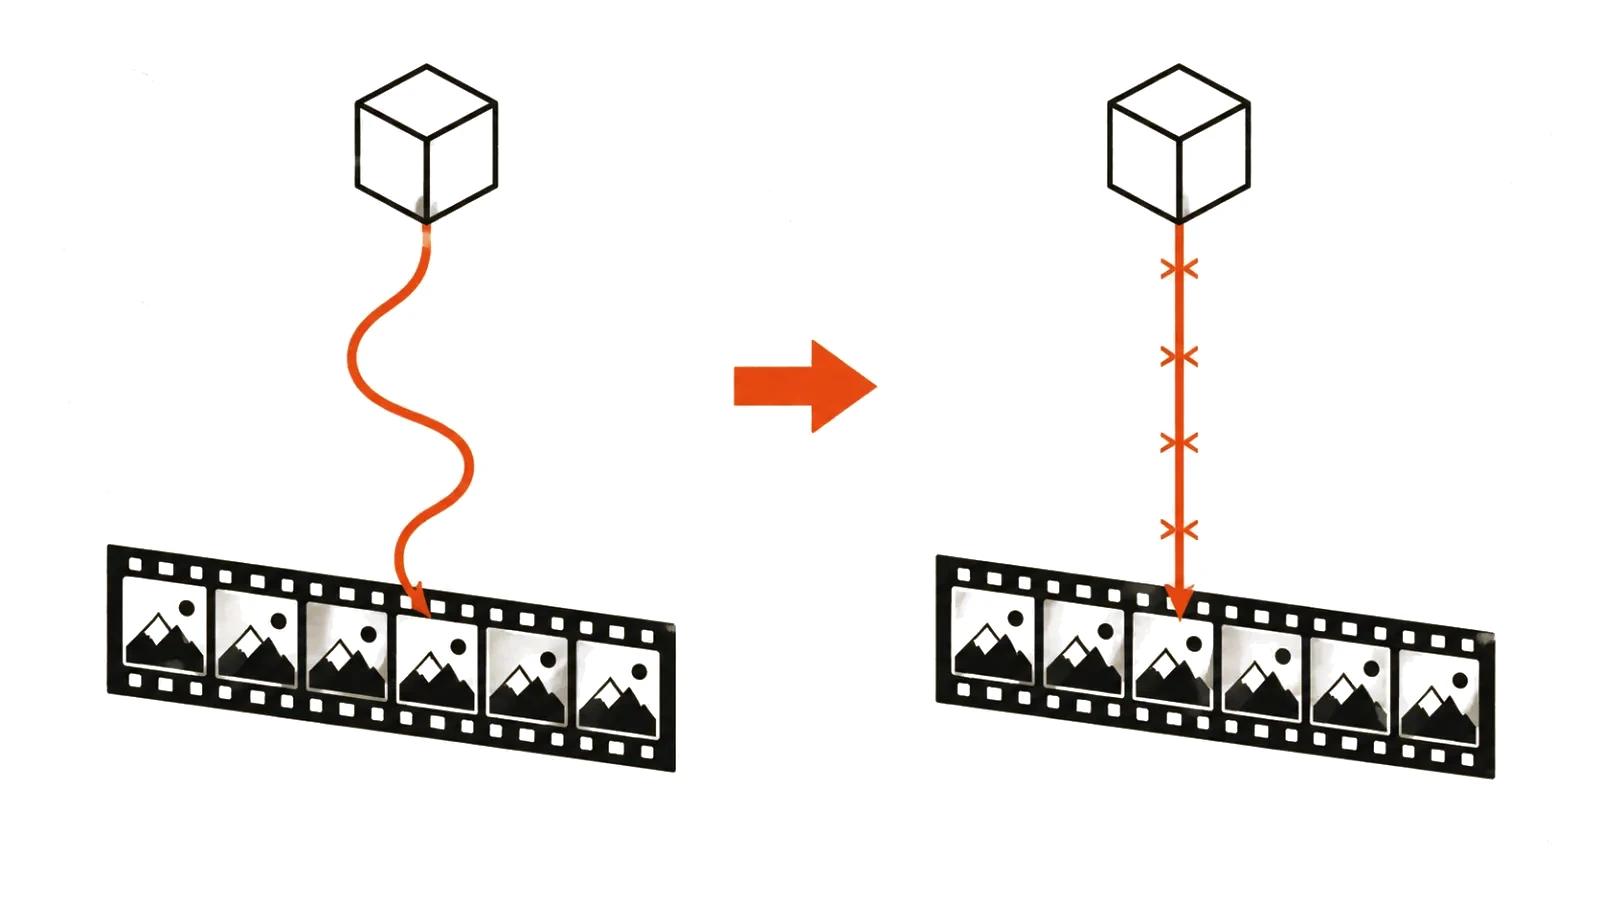
Авторы CausalAlign (Kai Zhu и коллеги) начали с диагностики. Они обучили линейные пробы на внутренних представлениях диффузионной видео-модели и посмотрели, где и как хранится информация о движении камеры. Картина оказалась неравномерной: точность представления сначала растёт по ходу денойзинга, а потом падает.
Дальше они вмешались в процесс причинно: усиливали и гасили отдельные слои и смотрели, что происходит с траекторией. Так нашлись слои, где движение камеры действительно формируется. На них исследователи и навели выравнивание с трёхмерной фундаментальной моделью, причём по дельте между соседними кадрами. Дельта описывает изменение сцены, поэтому выравнивание цепляется за движение камеры и не тратит ёмкость на статичные детали.
Результат они показывают на Wan2.2, дообученной на DL3DV и RealEstate10K. По их замерам геометрическая согласованность выросла больше чем на 20% относительно базовой модели, а успешность мировых моделей действий на мобильных манипуляциях в RoboCasa365 прибавила 10 пунктов.
Почему это важно: дрожащая камера это первое, что замечает заказчик в ролике про помещение или товар, и первое, что приходится чинить руками при монтаже.
Attn-Forcing: как удержать контекст, когда кадры идут потоком
Потоковая генерация устроена иначе, чем генерация клипа. Кадры приходят один за другим, и модель должна помнить, что было раньше: лицо героя, свет, положение предметов. Чем длиннее история, тем больше вычислений уходит на внимание, и в какой-то момент память заканчивается.
Attn-Forcing предлагает компромисс. Полный контекст модель не держит: она хранит набор обучаемых визуальных латентов, которые постепенно приближают отклик внимания от всей истории. Отдельный модуль обновляет эти латенты по мере поступления новых кадров, а функция потерь на согласование внимания следит, чтобы приближение не расходилось с полным контекстом.
Звучит как инженерная мелочь, но заявка серьёзная: авторы говорят о качестве на уровне лучших базовых методов при ограниченной памяти и вычислениях. Статья на 16 страниц, шесть рисунков, сравнение с существующими подходами к выбору и сжатию контекста.
Почему это важно: именно память определяет, можно ли собрать длинную сцену одним проходом или её придётся склеивать из кусков, а склейка всегда видна.
CADRE: автоэнкодер как отдельная деталь, которую пора проектировать
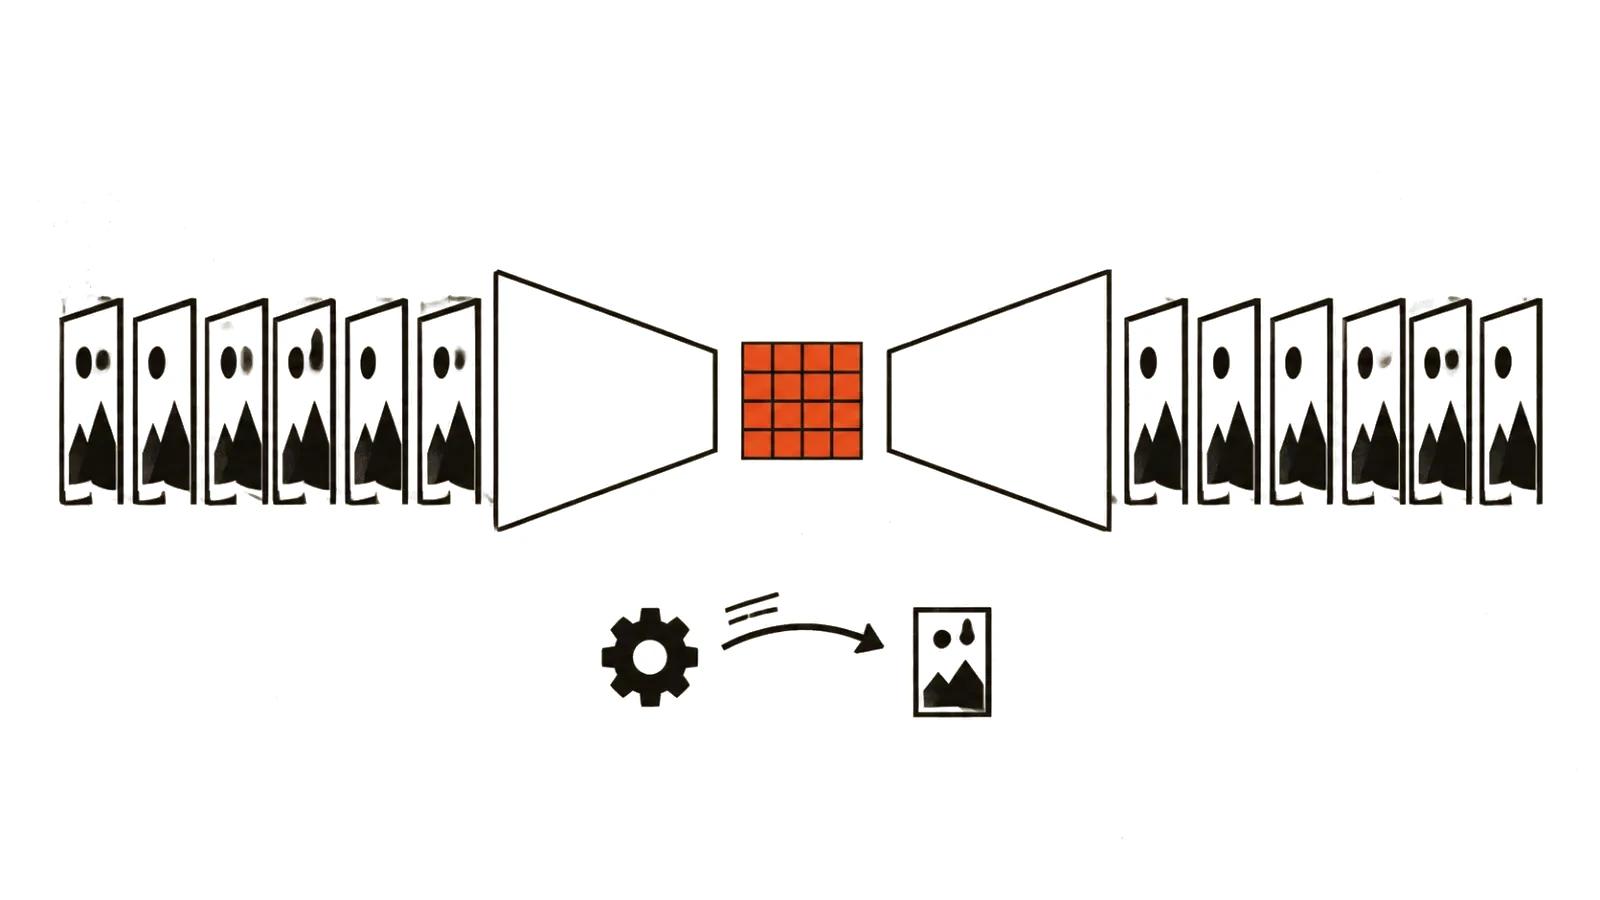
Работа Kyutai (совместно с LIGM, ENPC и UC Berkeley) начинается с бытового наблюдения. Видео-мировые модели не генерируют пиксели напрямую: сначала автоэнкодер сжимает кадры в компактное латентное пространство, и уже там модель предсказывает будущее. Почти все берут автоэнкодер от генератора видео, который делали для офлайн-клипов, где никто не ждёт реакции на действие.
CADRE это семейство открытых каузальных автоэнкодеров с разным сжатием по времени и по пространству. Внутри замороженный энкодер DINOv3 ViT-B/16, небольшая обученная горловина и диффузионный декодер, который сжимает обратно за один или два шага. Авторы обучили одну и ту же мировую модель на каждом варианте сжатия, в двух доменах (манипуляция и навигация) и двух средах в каждом.
Цифры, которые проще всего проверить: вход 288 на 512 пикселей при 20 кадрах в секунду, генерация в реальном времени на одной H100, задержка между действием и картинкой в примере с 16-кратным пространственным сжатием около 321 миллисекунды. Веса, код и демо открыты, но лицензия на модели CC BY-NC 4.0, то есть без коммерческого использования.
Четыре вывода, которые переживут конкретную модель
Первый: при сильном сжатии диффузионный декодер даёт более резкую картинку, чем перцептивная регрессия. Второй: в роботизированной манипуляции сжатие по времени выгоднее делать в автоэнкодере, чем в самой мировой модели. Третий: манипуляция и навигация требуют противоположных компрессий. Четвёртый, самый неожиданный: при неподвижной камере грубые пространственные токены бьют по движению сильнее, чем по качеству картинки.
Почему это важно: это правило подсчёта бюджета кадра, и оно переживёт конкретный чекпойнт. Если сжатие выбрано под задачу, тот же GPU отдаёт больше кадров в секунду.
Что это меняет для бизнеса
Для заказчика ролика всё это переводится в три вещи: цена секунды, стабильность камеры и длина сцены без склеек. Изготовление видео с помощью нейросетей давно упирается в пересчёт неудачных дублей, и любая работа, которая снижает стоимость кадра, меняет смету.
Второй эффект тоньше. Устойчивая камера и длинный контекст это то, без чего не собрать автоматизированный YouTube-канал: выпуски идут подряд, и в каждом следующем герой должен выглядеть так же, как в предыдущем. По той же причине массовые вертикальные ролики с одним лицом в кадре выигрывают от стабильности сильнее, чем одиночный имиджевый клип.
Третий эффект касается выбора инструмента. Обзор нейросетей для видео обычно сравнивает картинку, а эти три работы напоминают, что сравнивать надо ещё задержку, память и цену кадра. Модель, которая красиво рисует десять секунд, и модель, которая держит лицо минуту, это разные инженерные задачи.
Кому это пока не поможет
Ни одна из трёх работ не даёт продукта с тарифом и поддержкой. CADRE это исследовательский релиз с некоммерческой лицензией, Attn-Forcing и CausalAlign это статьи с обещанием кода, без тарифа и поддержки. Замеры сделаны авторами на своих наборах данных, независимой проверки на чужих задачах нет.
Отдельно стоит помнить про домен. CADRE обучен на манипуляции и навигации, CausalAlign проверен на Wan2.2 и двух наборах данных о сценах. Переносить выводы на рекламный ролик с актёром и монтажными склейками можно только как ориентир.