Что вышло 20 октября
Работа SolarRenderer: Few-Step Generative Reference Rendering (https://arxiv.org/abs/2610.28630) появилась на arXiv 20 октября в 17:59 UTC, это технический отчёт на 28 страниц. В тот же день авторы выложили веса на Hugging Face, код на GitHub, набор данных отдельным репозиторием и страницу проекта.
Идея простая на словах. Игровые движки и кодовые агенты умеют задать планировку, движение и камеру, но картинка на выходе остаётся серой коробкой. Нужен рендерер, который сохранит структуру и дорисует то, что структура не задаёт: материалы, свет, фактуру.
Что было до этого. Открытые рендереры привязаны к представлению одного движка, требуют десятков шагов денойзинга или дорогой дистилляции под каждый случай, а учатся на условиях, которые не совпадают с целевым видео. Авторы заявляют, что обходят все три ограничения сразу: одно управление на разные структуры, четыре шага, выравнивание по кадрам при обучении.
Как устроен рендер по структуре
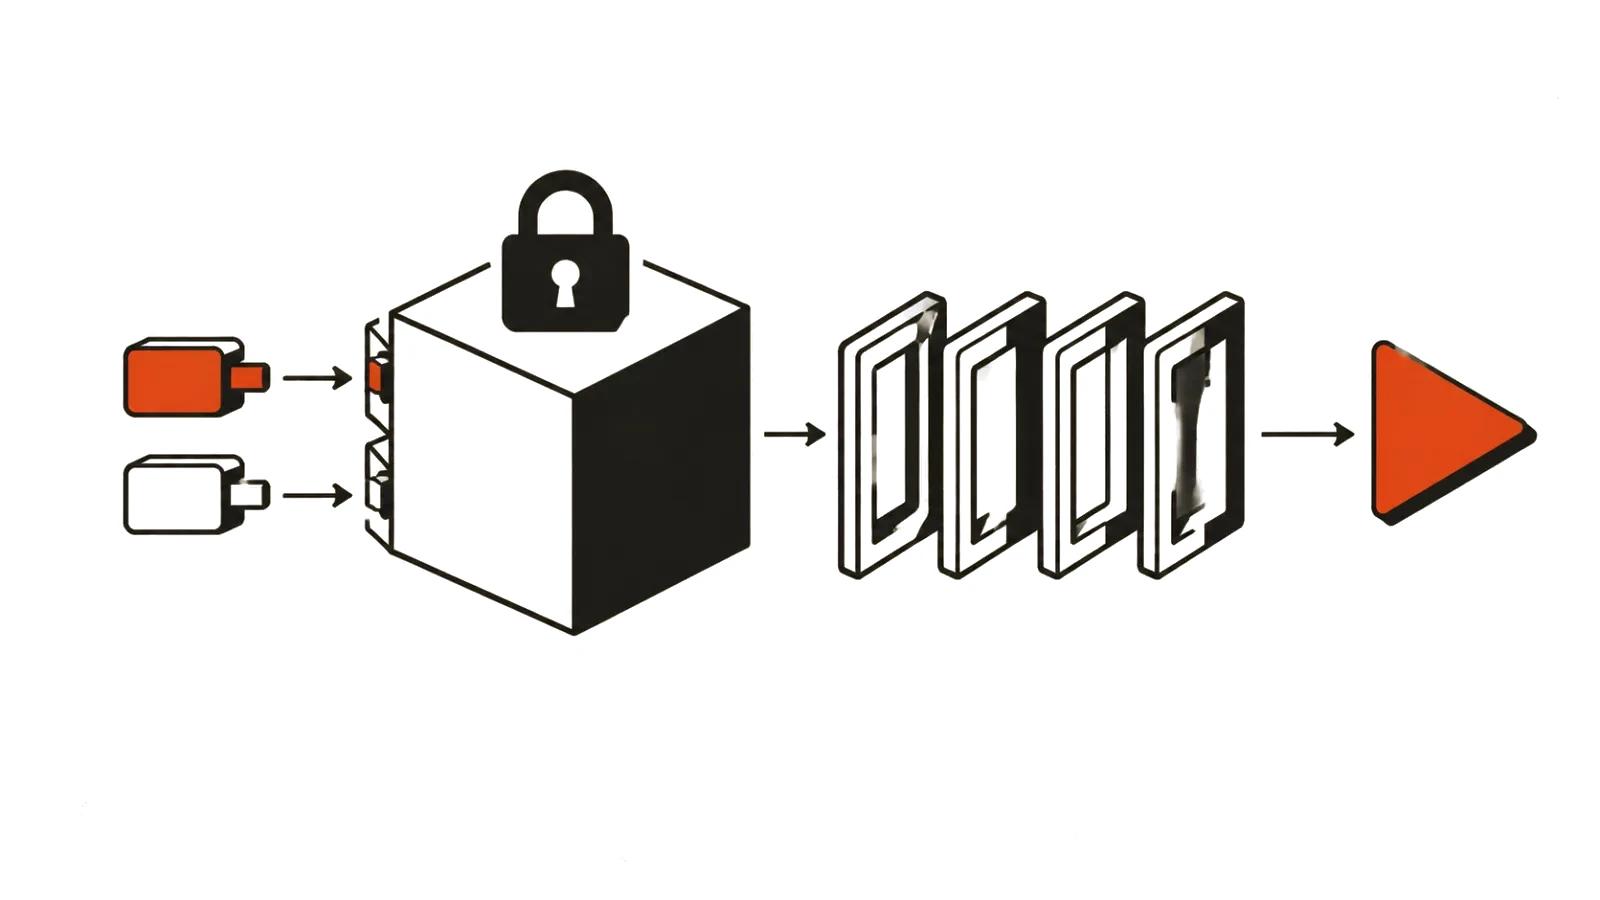
Авторы не обучали новую модель с нуля. Они взяли замороженную MiniMax-H3 на 33 миллиарда параметров и добавили две лёгкие LoRA. Первая отвечает за управление: структурное видео попадает во врождённый референсный путь модели в те позиции, которые кадр описывает. Вторая отвечает за скорость и получается из четырёхшаговой LoRA, дообученной согласованием распределений с учётом структуры.
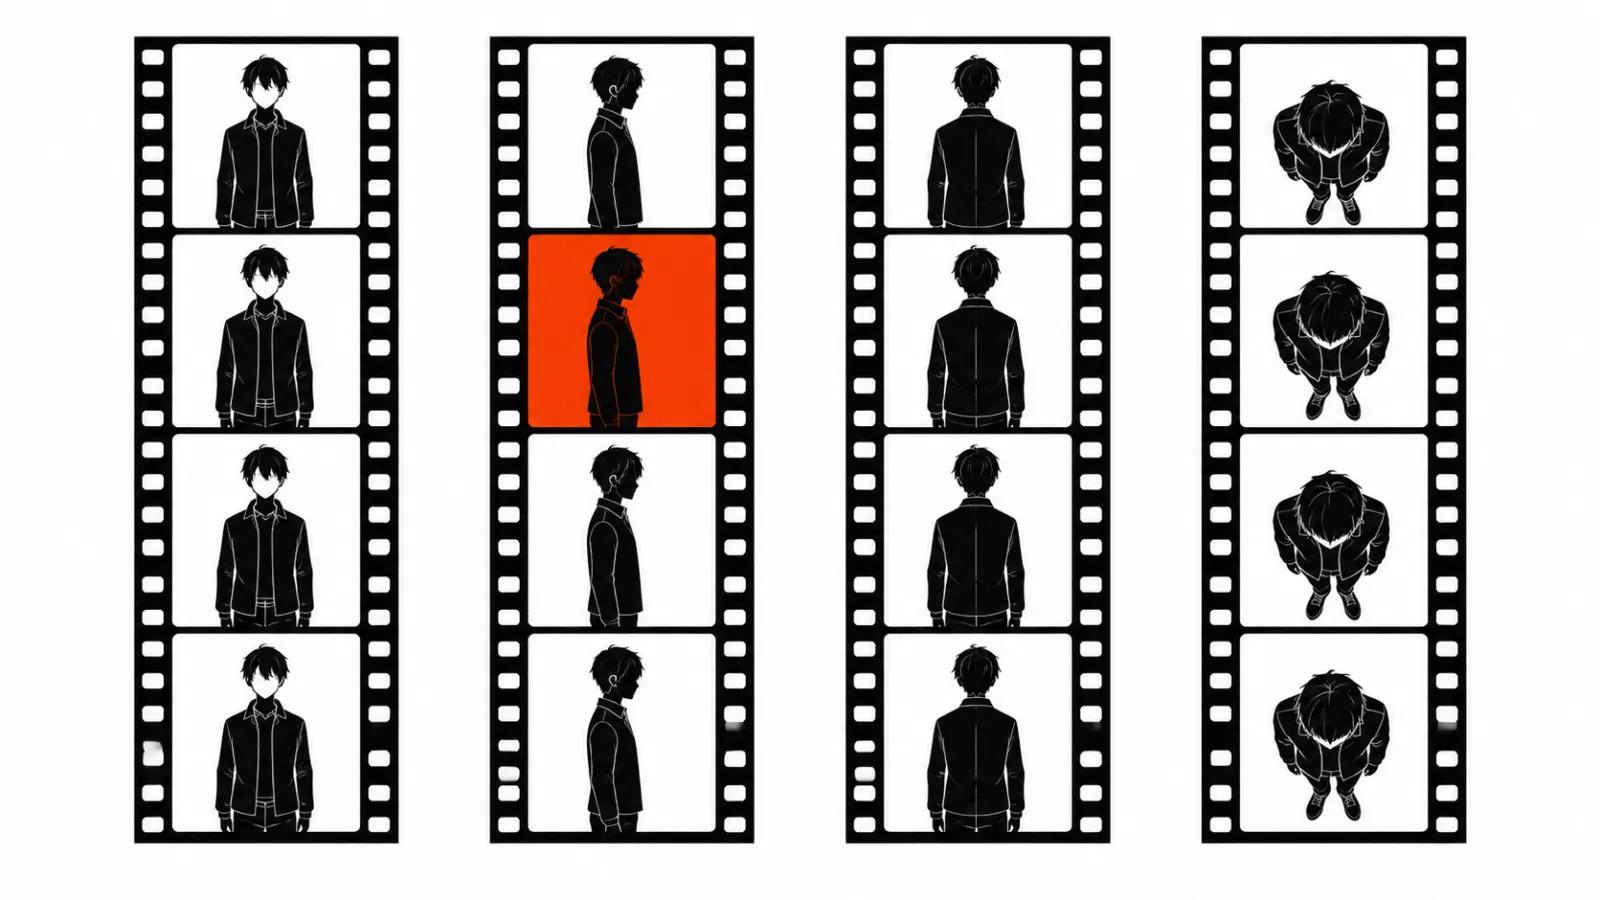
Важная деталь: тип структуры модели не сообщают. Никаких меток «это глубина» или «это скелет», только обычный текст. Поэтому одна и та же LoRA тянет разные представления: серые коробки, семантические карты, скелеты, карту глубины, меш тела, карандашный набросок. Набросков в обучении не было, но модель их принимает.
На карточке модели указан выход 1344 на 768 пикселей или 768 на 1344, 24 кадра в секунду, 158 кадров, около 3,5 минуты сэмплирования на одной видеокарте. Модель карты не называет.
Четыре шага и 12,3 раза: что за цифрами
Число шагов это главный аргумент статьи. Авторы сообщают, что рендер идёт за четыре шага денойзинга и это в 12,3 раза быстрее сэмплирования за 50 шагов, при этом управление структурой не теряется.
Сравнение честное по методике: обе цифры получены на одном наборе, разница только в числе шагов. Но замеры сделаны авторами, независимой стороны в них нет. Насколько 12,3 раза переносятся на другую видеокарту и другие настройки, из препринта не следует.
Обучение шло на корпусе из 136 тысяч клипов с игровых движков, симуляторов и YouTube. Кадры выровнены по структуре: у каждого структурного кадра есть соответствующий кадр готового видео. Это и позволяет учить управление без разметки типов.
Потоковый вариант: 768p в реальном времени
Отдельная ветка работы это потоковый рендер. Причинная версия рисует видео блоками до пяти латентных кадров. Каждый блок видит промпт, первый кадр, структуру последних шести блоков и пять уже отрисованных блоков, но никогда не видит будущее. Поэтому картинку можно показывать по мере готовности.
По заявлению авторов, этот вариант отдаёт 768p в реальном времени. Условия замера в абстракте не раскрыты: какая карта, какая длина ролика, что считается реальным временем. Для практики это самое интересное обещание и самое непроверенное.
Лицензия: длинный список исключений
Веса это LoRA-адаптеры поверх MiniMax-H3, и они идут под лицензией MiniMax H3 Community License. В карточке модели прямо перечислены территориальные ограничения: Европейский союз, Великобритания, Республика Корея и Соединённые Штаты. Код открыт под Apache 2.0, данные лежат отдельно.
Для заказчика это важнее скорости. Команда в Берлине или Сеуле не может просто взять веса и поставить их в продакшн. Российская студия в список исключений не попала, но лицензия содержит и другие условия, которые стоит читать целиком, вместе с приложениями.
Что именно считается использованием по этой лицензии, лучше уточнить у юриста: текст ссылается на отдельную политику допустимого использования, а территориальные ограничения перечислены отдельным пунктом. Проверять стоит и место, где будет стоять модель, и место, где находится заказчик.
Экосистема вокруг релиза
За сутки вокруг работы появились сторонние обвязки. Узел ComfyUI от стороннего разработчика создан 20 октября в 12:15 UTC, то есть в тот же день. Квантованная сборка FastH3 Omni в формате GGUF появилась вечером 20 октября, в 21:12 UTC: это уже про локальный запуск родственной модели на потребительском железе.
Репозиторий с кодом SolarRenderer на GitHub создан 15 октября и к утру 21 октября собрал больше двухсот звёзд. Это не показатель качества, но показывает скорость, с которой сообщество подхватывает подобные релизы.
Что это значит для заказов на видео
Открытые нейросети для видео становятся практичным инструментом там, где структура уже есть. Рекламный раскадровочный блок-аут, планировка помещения, движение камеры по сцене: всё это можно превратить в черновик за минуты, тогда как раньше это была смена художника.
Такой вход в проект меняет и изготовление видео с помощью нейросетей: клиент приносит грубую геометрию вместо референса, и получает картинку, которая следует его замыслу. В такой схеме ручные ролики никуда не уходят: актёрская игра и драматургия по-прежнему снимаются людьми, от 16 000 ₽ за ролик до 90 секунд, срок около недели.
Для потоковых проектов интереснее потоковый вариант: если 768p в реальном времени подтвердится на обычном железе, массовые вертикальные ролики можно будет собирать пачками без очереди на рендер. Пока это обещание авторов.
Тем, кто выбирает инструмент, стоит держать под рукой обзор нейросетей для видео: там модели разложены по задачам, и громкое название не заменяет проверку на своём материале.