Что показала ElevenLabs
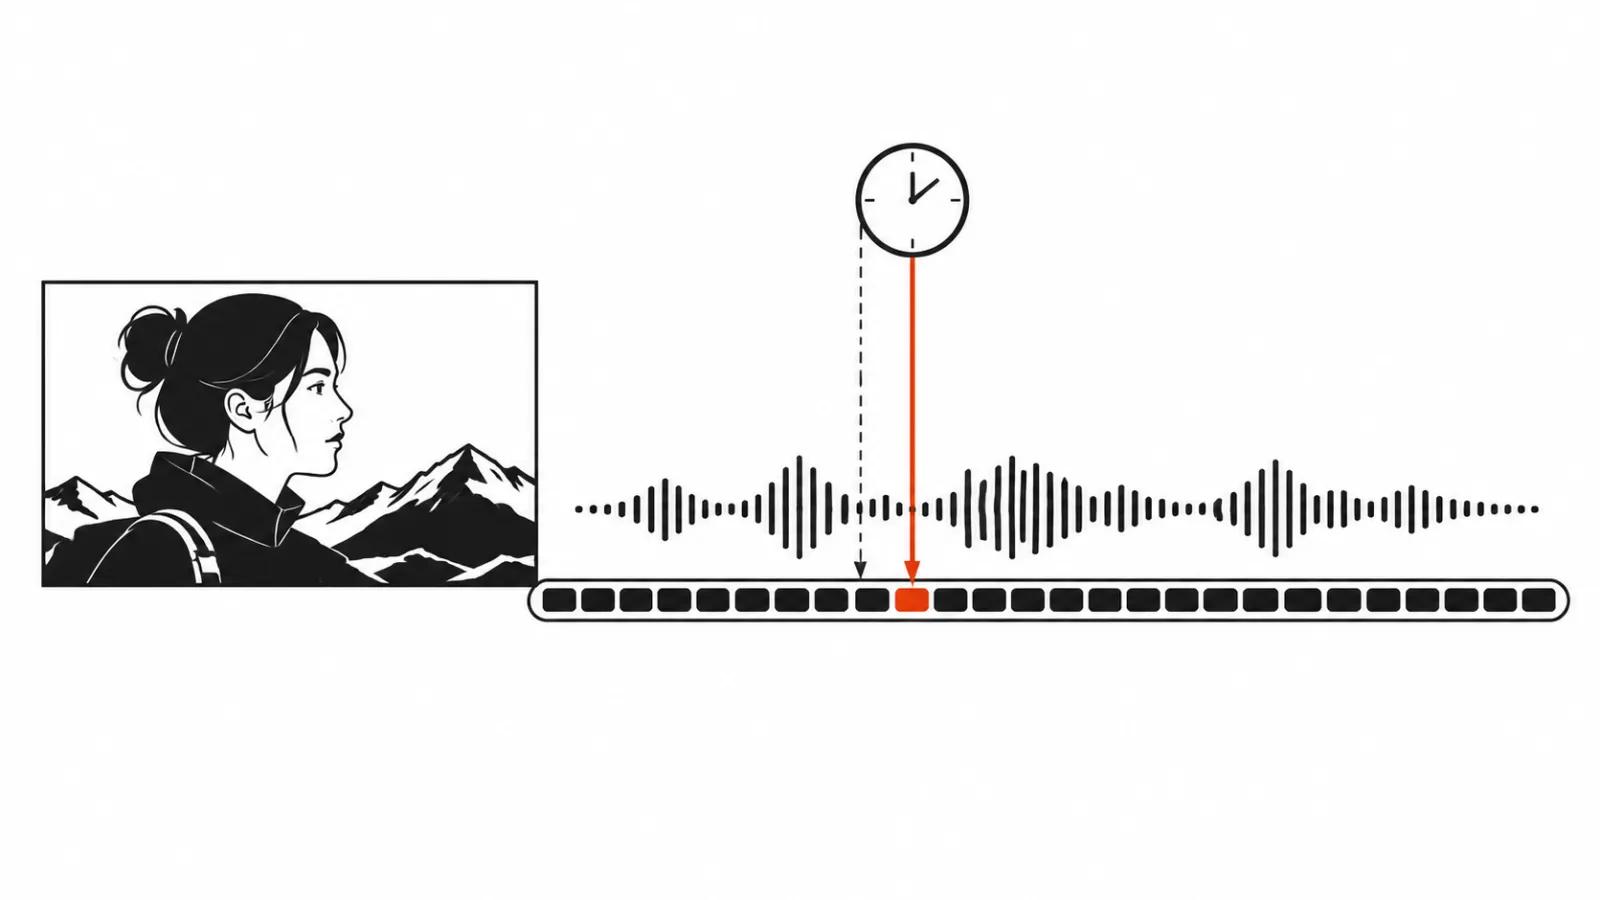
28 октября 2026 года, в 12:00 UTC, ElevenLabs опубликовала разбор модели Cue. Это модель принудительного выравнивания: она получает аудио и текст и расставляет каждый символ на таймлайне записи.
Cue не отдельный продукт для узкой задачи. По описанию компании, она стоит последним шагом в конвейере распознавания речи и работает за каждой расшифровкой семейства Scribe. Субтитры, дубляж и тайминги текста песен тоже идут через неё. Отдельно модель доступна через Forced Alignment API.
Формулировка «каждый символ» здесь важна. Большинство инструментов выдаёт границы слов, и внутри слова уже начинается приблизительность. Cue целится в символ, а значит, подсветка караоке и пословный переход в субтитрах встают точнее.
Зачем это нужно в ролике
Выравнивание решает простую задачу: сопоставить текст и звук по времени. Когда субтитр появляется на долю секунды позже реплики, зритель это замечает, даже если не понимает, что именно ему мешает.
В дубляже та же ошибка выглядит хуже. Реплика актёра должна попадать в артикуляцию, и сдвиг в 200 миллисекунд уже читается как чужая озвучка.
В производстве это отдельный этап: сначала расшифровка, потом сверка таймингов, потом ручная правка. Чем точнее выравнивание, тем короче правка, и тем меньше роликов возвращается из контроля качества.
Почему длинные файлы съезжают
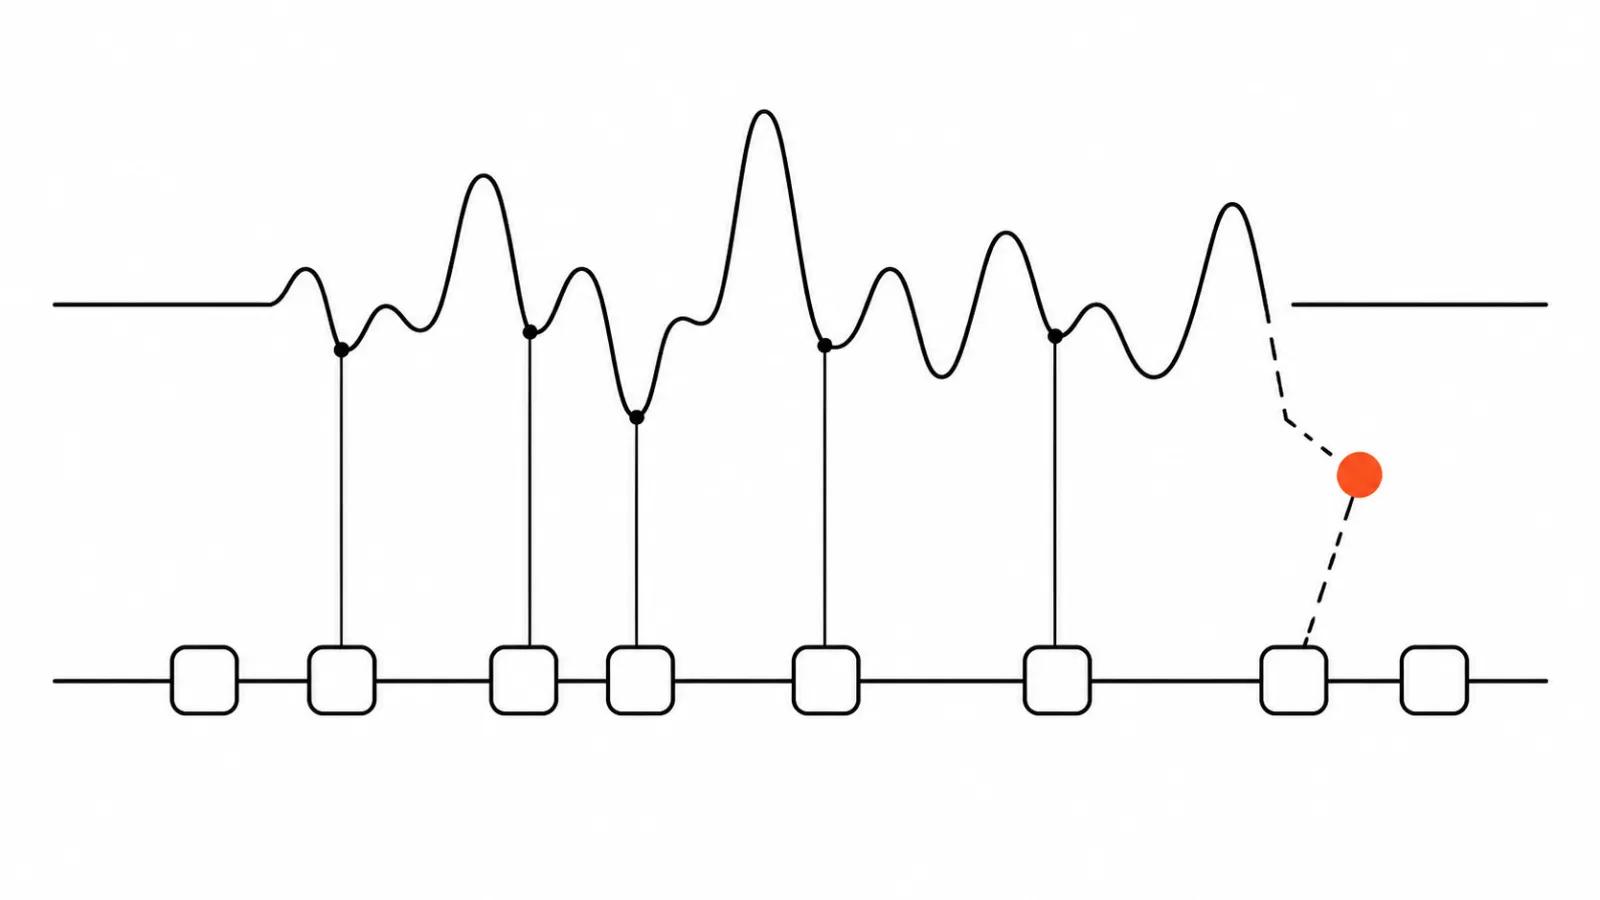
Проблема старых инструментов в длине. Многие модели уверенно работают на клипах около 30 секунд, а длинные записи приходится резать на куски. Каждый стык добавляет небольшую ошибку, и на длинном файле они складываются.
По данным ElevenLabs, средняя ошибка Cue на полных записях 179 миллисекунд. У открытых инструментов из сравнения разброс от 283 миллисекунд до более чем 6 000 миллисекунд.
Второй источник ошибок это грязный звук. Фоновый шум, накладывающиеся голоса и музыка сбивают сопоставление. На английских записях с такими помехами у Cue средняя ошибка 57 миллисекунд, у остальных от 65 до 920 миллисекунд.
Cue обрабатывает запись целиком за один проход. Именно это, по словам компании, убирает накопление ошибки на стыках.
Скорость и языки
Час аудио Cue выравнивает примерно за полсекунды на продакшн-GPU. Следующий по скорости инструмент, Qwen3-ForcedAligner, тратит почти две секунды, самый медленный из сравнения больше минуты.
Языков в одной модели больше 90, в бенчмарке компания проверяла 29. Из открытых инструментов все 29 языков закрывает только MMS-FA, и на нём Cue обычно быстрее находил границы слов.
Скорость здесь не про рекорд. Она про то, что выравнивание можно ставить в конвейер и не думать о пакетной обработке: тысяча роликов перестаёт быть отдельным проектом.
Песни и караоке
Музыка считается сложным случаем, потому что пение растягивает и размывает слова. На подборке песен из открытого набора JamendoLyrics MultiLang модель работала на английском, французском, испанском и немецком за один проход.
Результат: 92,7% слов попали в окно 0,3 секунды от разметки, у следующего инструмента 82,0%. Средняя ошибка начала слова 0,82 секунды, примерно вдвое меньше, чем у ближайшего конкурента. На 19 песнях из 22 модель оказалась точнее остальных.
Для видео это открывает караоке-субтитры и лирические клипы, где текст подсвечивается по слогам. Раньше такую разметку делали руками или забивали на точность.
Где всё ещё нужен человек
Компания честно называет границу: на уровне символов человеческое восприятие заканчивается, и проверить «идеально» уже нечем. Автор разбора приводит слова исследователя о том, что модель обогнала человеческую точность, и потому измерить её полностью не получается.
Практический вывод из этого простой. Выравнивание перестаёт быть местом, где ловят брак, и это меняет роль редактора: он проверяет смысл и произношение, а сдвиг на полсекунды перестаёт быть его работой.
Остаются и обычные ограничения. Диалекты, акценты и профессиональные термины всё равно требуют проверки. Ремонт грузинского и ещё пары языков компания сделала меньше чем за сутки после жалобы клиента, и это хороший пример того, что модель живёт за счёт обратной связи.
Что это меняет для производства
Первое: субтитры и дубляж перестают быть отдельной статьёй сметы, где заложены часы на сверку. Если выравнивание точное, эти часы уходят в контроль, а ручная подгонка занимает минуты.
Второе: массовые вертикальные ролики становится дешевле собирать из одного исходника. Каждая версия получает свои субтитры и свою озвучку, и синхронизация не превращается в отдельную смену.
Третье: уникализация видео получает аккуратный инструмент. Когда меняется голос или язык, тайминги текста должны ехать вместе с ним, и точное выравнивание снимает часть ручной работы.
Для команд, которые делают видео нейросетями в объёме, это означает ещё одну вещь. Выравнивание можно держать как шаг конвейера, без отдельного сервиса, куда отправляют файл и ждут ответа. Один и тот же ролик на пяти языках перестаёт требовать пяти отдельных сверок: тайминги приходят из модели, а человек смотрит смысл.
Вывод
Cue это редкий случай, когда компания показывает проценты ошибки и список конкурентов. Цифры 179 и 57 миллисекунд звучат скромно, но именно они отделяют любительские субтитры от тех, что не отвлекают от ролика.
Мой совет: возьмите свой худший файл, тот, где шум, две речи и термины, и сравните выравнивание на нём. Если разница видна на глаз, инструмент стоит встроить в конвейер. Если нет, у вас уже всё в порядке.