Что вышло 17 октября
17 октября 2026 года в 08:35 UTC DeepSeek объявила в X: «DeepSeek-V4.1-Flash-1017 is here!» В анонсе — улучшенные бенчмарки, более быстрое выполнение задач, более короткие ответы, а формулировка про результат звучит как «Pareto improvement in performance and cost». Модель доступна на сайте компании, в приложении и через API; заявлена оптимизация под DeepSeek Harness, Tencent CodeBuddy и WorkBuddy.
В том же треде разработчик добавил существенную деталь: модель обучена с RL и самопроверкой (self-feedback) для сквозной разработки проектов — от создания игр до 3D-моделирования. Веса открыты на Hugging Face и ModelScope. Там же открыли Search & Fetch API: по прайсу DeepSeek это около 63 ₽ за 1000 вызовов на один эндпоинт (пересчёт по курсу 84 ₽).
Почему языковая модель оказалась в разговоре про видео
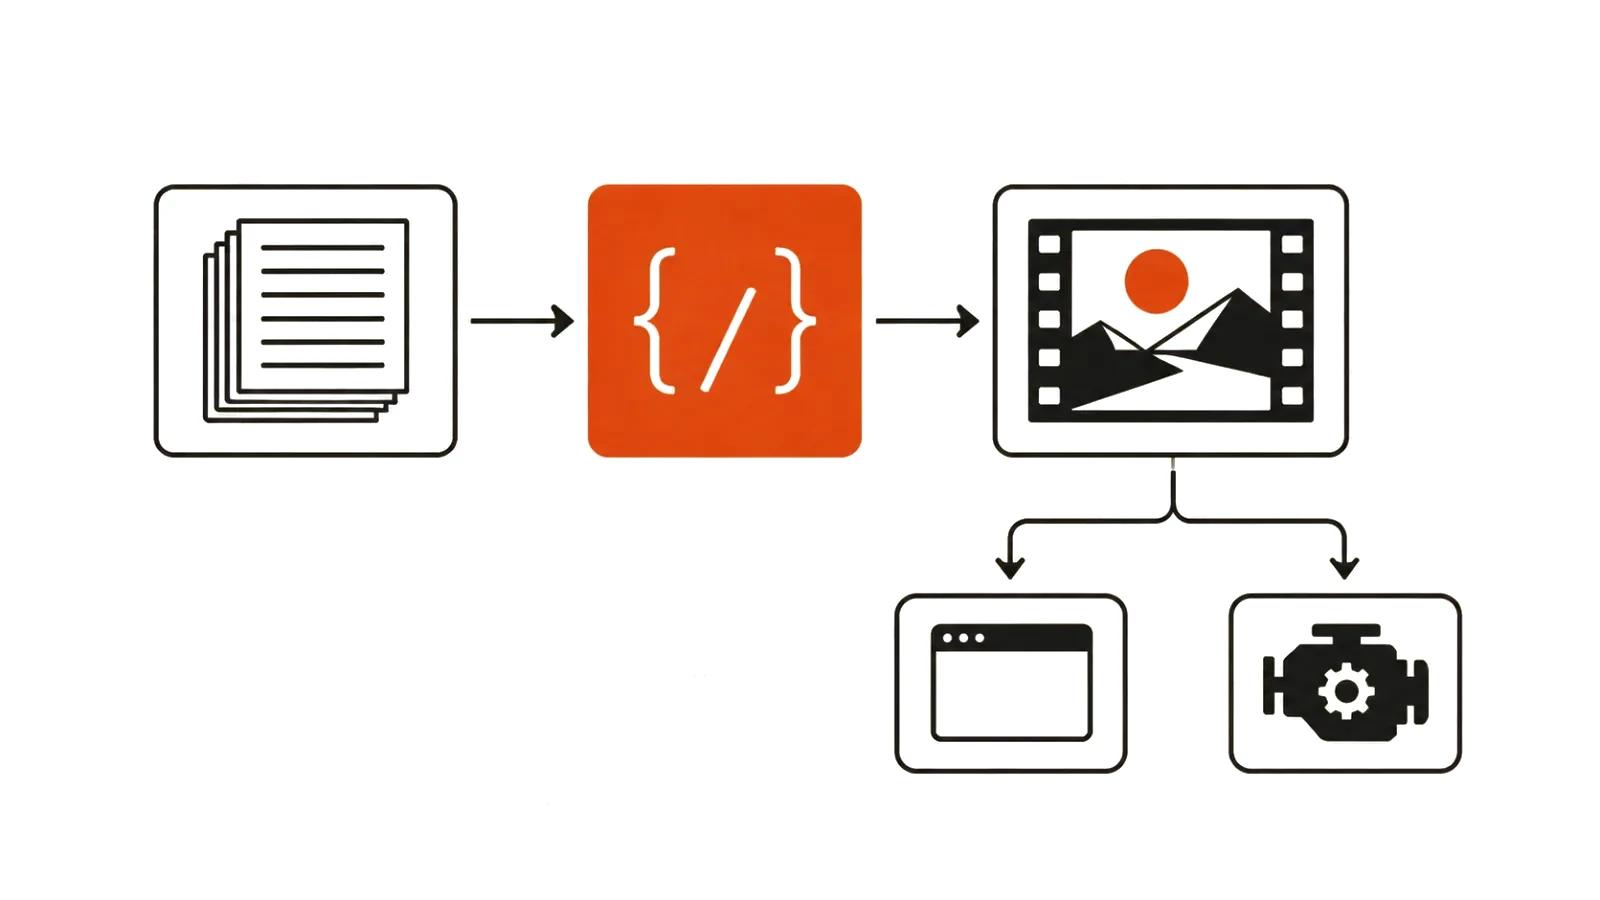
Схема называется «видео кодом»: модель пишет код анимации — HTML, CSS, JS, 3D-сцены — а этот код рендерится в готовый ролик. Получается не сгенерированный кадр, а описанная и затем отрисованная сцена.
Что так делается на практике:
Ключевое отличие от генеративного видео — управляемость. Код можно открыть, поправить, перезапустить рендер и получить предсказуемый результат: тот же кадр, только с исправленной деталью. Классический пайплайн для этого — After Effects и ручная анимация; здесь тот же слой работы пытаются закрыть моделью, которая пишет код сцены.
Если задача — изготовление видео с помощью нейросетей, то «видео кодом» стоит в одном ряду с другими подходами, но решает свою часть: там, где нужен контролируемый дизайн и повторяемость.
- моушн-дизайн: титры, переходы, динамические плашки;
- интерфейсы и экраны продуктов: анимация элементов, демонстрация сценариев использования;
- инфографика и данные: графики, счётчики, диаграммы в движении;
- лончи продуктов: короткие презентационные ролики, где важнее аккуратная типографика и ритм, чем фотореализм.
Что показала Higgsfield
Официальный аккаунт Higgsfield (@higgsfield_ai) 17 октября, в промежутке 16:32–20:32 UTC, выложил серию сравнений, сделанных на их площадке. Ключевая формулировка из поста 16:46 UTC: «DeepSeek V4.1 Flash looks like the new SOTA for motion design» — около 1,4 тыс. лайков.
Что было в серии:
Важная оговорка: это демо-сравнения самой площадки, независимым бенчмарком они не являются. У таких тестов есть смещение — и по выбору задач, и по тому, что публикуют именно удачные результаты. Смотреть на них стоит как на демонстрацию возможностей конкретного инструмента.
- в 16:32 UTC — лонч-видео «with actual art direction… 3D, halftone, and pixel art»;
- сравнения с Claude Opus 5.5: 3D-моделирование, симуляция воды, сцена «floating island»;
- сравнения с Gemini 4 Argon: ink animation, «flying car kickflip»;
- в 18:34 UTC — анимационный тест четырёх моделей: Gemini 4 Argon против GPT-6.1 Soul, Claude Opus 5.5 и DeepSeek V4.1 Flash.
Что говорит changelog
В документации DeepSeek (api-docs.deepseek.com/updates, запись от 17 октября 2026 года) указано: цена API и сам вызов не изменились, модель идёт под именем deepseek-flash. Там же приведены цифры: DeepSWE v1.1 — 77,0; Terminal-Bench 4.0 — 42,3; HLE без инструментов — 42,6. Плюс зафиксировано сокращение времени выполнения задач и длины вывода.
Это единственные числа, которые в этой истории стоит использовать как измерение: остальное — либо маркетинговые формулировки, либо демо.
Мнение из китайского сегмента
Пользователь @bourneliu66 (17 октября, 16:30 UTC) написал, что для «видео через код» модель «очень сильная» и «уступает только Claude Opus». Это мнение одного пользователя, тестом оно не подкреплено. Никакие версии о происхождении весов мы здесь не приводим: подтверждений у них нет.
Где «видео кодом» уместно, а где нет
Разделение простое и определяется тем, что должно быть в кадре.
Практическая связка выглядит так: вертикальная реклама в дизайнерской части собирается кодом — плашки, цифры, переходы, а живые сцены идут с генерации или со съёмочной площадки. Ориентиры по деньгам у нас не поменялись: ручной ролик до 90 секунд с проработкой сценария и монтажом — от 16 000 ₽, массовые форматы считаются по просмотрам — от 0,10 ₽ за просмотр.
- Уместно: дизайн-графика, интерфейсы, инфографика, титры, лончи. Всё, что можно описать правилами и собрать из векторных элементов и 3D-сцен.
- Уместно для потока: шаблонный ролик по одной и той же схеме. Когда нужен тираж, скажем массовые вертикальные ролики с одинаковой структурой и разным содержимым, кодовая анимация даёт дешёвую повторяемость — сцена пересобирается без съёмки и без ручной перекладки кадров.
- Не заменяет видеогенераторы: Kling, Seedance, Veo и другие модели нужны там, где в кадре живые люди, сложная камера, естественный свет и материальные детали, которые дорого воспроизводить графикой. Для рекламы с человеком в кадре это по-прежнему другой инструмент.
- Не заменяет съёмку: реплики, мимику и продуктовые съёмки код не отрисует.
Что проверить, если берёте подход в работу
Стек: кто и чем рендерит код — в браузере или в отдельном движке. От этого зависит и качество, и время сборки.
- Повторяемость: попробуйте дважды собрать один и тот же кадр. Если результат стабилен, шаблон можно масштабировать.
- Шрифты и лицензии: графические ассеты и гарнитуры подчиняются правам так же, как музыка и стоки.
- Резкость под вертикаль: мелкие подписи и тонкие линии требуют отдельной проверки на телефоне.
- Где вход человека: правки в код дешевле правок в сгенерированном видео, это стоит использовать как способ приёмки.
- Сверяйте подходы по актуальности: быстрый способ — справочник нейросетей для видео 2026, там же видно, какая модель под какой сценарий подходит.