Озвучка видео нейросетью: что это и как работает
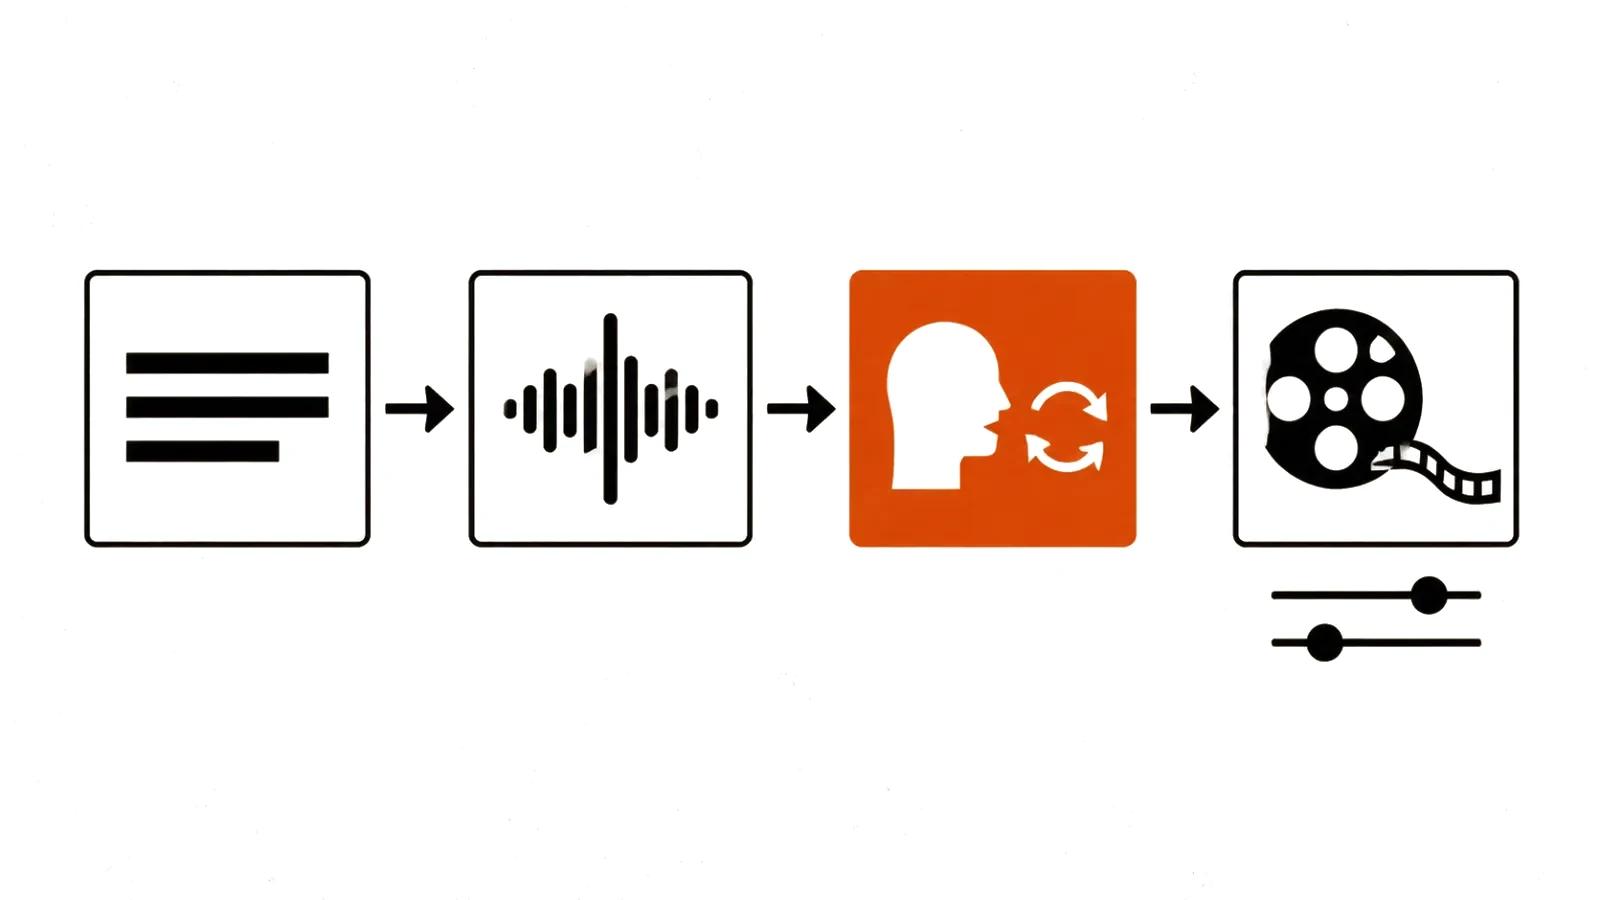
Озвучка нейросетью — это синтез речи по тексту: модель получает реплику и выдаёт аудиодорожку с заданным голосом, темпом и интонацией. Человек больше не записывает каждый дубль в студии, но решает, какой голос нужен, где пауза и какое слово главное в фразе.
Есть четыре основных сценария. Закадровый голос — диктор, который ведёт ролик. Голос персонажа — реплики героя в кадре, часто вместе с лип-синком. Дубляж — перевод готового ролика на другой язык с сохранением тембра. И голос, встроенный в генерацию: часть видеомоделей сразу выдаёт картинку со звуком и речью.
Для коротких роликов озвучка нейросетью — уже стандарт. Изготовление видео с помощью нейросетей почти всегда включает синтез голоса, потому что записывать диктора под каждую версию ролика дорого и долго. То же и в вертикальной рекламе: под каждый тест нужен свой голос, и живой диктор тут не успевает.
Как сделать ИИ-голос для видео: пошагово
Напишите текст для уха, а не для глаза: короткие фразы, без скобок и сокращений, числа словами там, где важно произношение.
- Выберите голос под аудиторию: возраст, тембр, манеру. Голос рекламы бытовой химии и голос обучающего курса — разные голоса.
- Сгенерируйте несколько дублей одной фразы и выберите лучший. Синтез, как и генерация видео, даёт разброс.
- Поправьте ударения и паузы: в большинстве сервисов есть разметка или фонетические подсказки.
- Сведите голос с музыкой и эффектами. Голос, положенный на музыку без обработки, звучит отдельно от ролика.
- Проверьте на телефоне. Большая часть роликов смотрится в ленте через динамик смартфона, и на студийных мониторах ошибки слышны иначе.
Клонирование голоса: что можно, а что нельзя
Клонирование голоса — это создание синтетической копии конкретного человека по образцу его речи. Для бизнеса это удобно: голос основателя или постоянного диктора можно использовать в десятках роликов без записи каждого.
Граница здесь юридическая и этическая. Клонировать можно только голос человека, который дал на это согласие, и только в тех рамках, на которые он согласился. Голос знаменитости, публичного человека или случайного автора из чужого ролика — это подделка, а не озвучка. Мы работаем только с голосами, права на которые есть у заказчика, и с готовыми синтетическими голосами сервисов.
Хорошая практика — письменное согласие с описанием, где и как будет использоваться голос, и пометка о синтетической речи там, где этого требует площадка или договор.
Лип-синк и дубляж на другие языки
Лип-синк — это подгонка движения губ персонажа под аудиодорожку. Он нужен, когда герой говорит в кадре крупным планом. На общих планах и в закадровом формате без него можно обойтись, и это заметно дешевле.
Дубляж нейросетью решает другую задачу: один ролик выходит на нескольких языках с тем же тембром диктора. Это основа роликов для разных гео, когда одно и то же сообщение нужно показать в нескольких странах. Здесь важно не только перевести текст, но и адаптировать его: шутки, единицы измерения и обращения на другом языке звучат иначе.
Отдельная проблема дубляжа — длина фразы. Немецкий или испанский текст обычно длиннее русского, и если не подрезать перевод, голос начинает торопиться.
Где ИИ-голос звучит фальшиво
Почти все эти ошибки исправляются не заменой сервиса, а работой человека: правкой текста, выбором дубля, сведением.
- Одинаковая интонация на всех фразах: модель читает ровно, и через десять секунд это слышно.
- Неправильные ударения в именах, брендах и редких словах.
- Слишком чистый звук без пространства: голос как будто записан в вакууме, а картинка — на улице.
- Эмоция не к месту: бодрый тон в ролике о серьёзной проблеме.
- Дыхание и паузы в неожиданных местах, особенно на длинных предложениях.
Что остаётся звукорежиссёру
Нейросеть генерирует голос, но не собирает звук ролика. Баланс голоса и музыки, эффекты под действие на экране, громкость под требования площадки, чистка артефактов синтеза — это по-прежнему работа человека.
Поэтому ручные ролики у нас включают монтаж, музыку и звук целиком, а не только синтез реплик. В массовых форматах звук собирается один раз в шаблоне формата и дальше меняется только текст и голос.
Озвучка в больших объёмах
Когда роликов сотни, озвучка становится частью конвейера: одна структура текста, несколько голосов под разные аудитории, версии на разных языках. Массовые вертикальные ролики без синтеза голоса просто не собрать: записывать живого диктора под каждую вариацию невозможно по срокам.
Главное правило объёма — проверять выборку. Даже при одинаковом шаблоне часть дорожек получится с ошибкой ударения или интонации, и лучше поймать это до публикации.