Что считаю видео из аудио
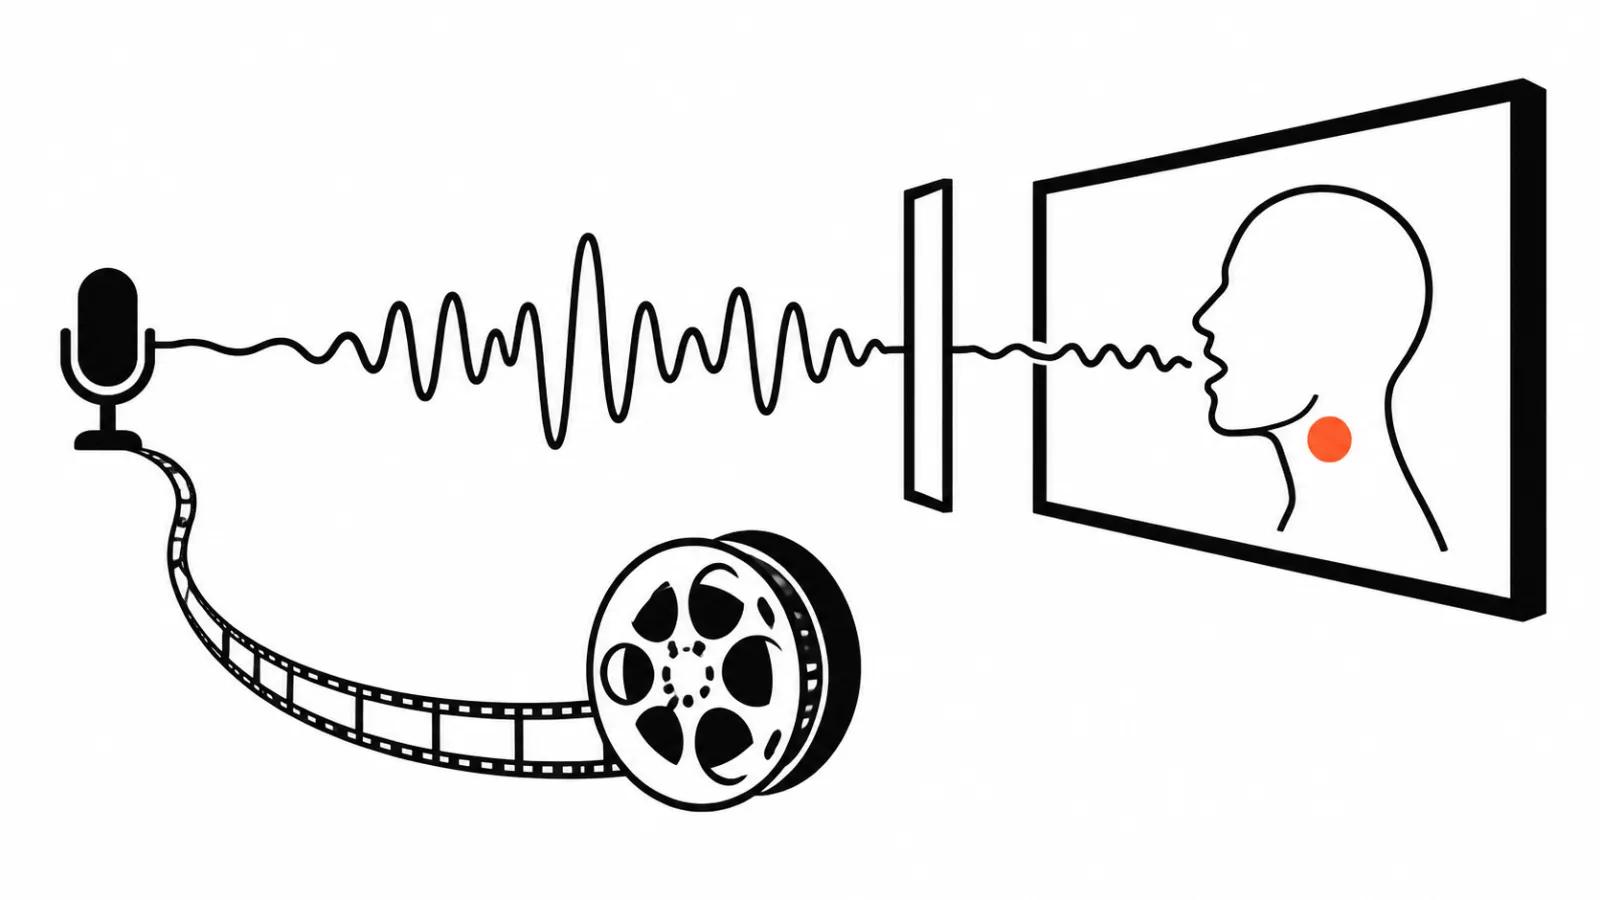
Видео из аудио начинается с файла, в котором уже есть речь или музыка. Нейросеть не придумывает содержание, она подбирает картинку под то, что звучит.
Отсюда главное отличие от генерации по тексту. Там модель рождает кадр и звук вместе, здесь звук первичен, и вся работа идёт вокруг него.
Второе отличие: длина задана дорожкой. Ролик длится столько, сколько длится запись, и это ограничивает и сервис, и терпение зрителя.
Три пути
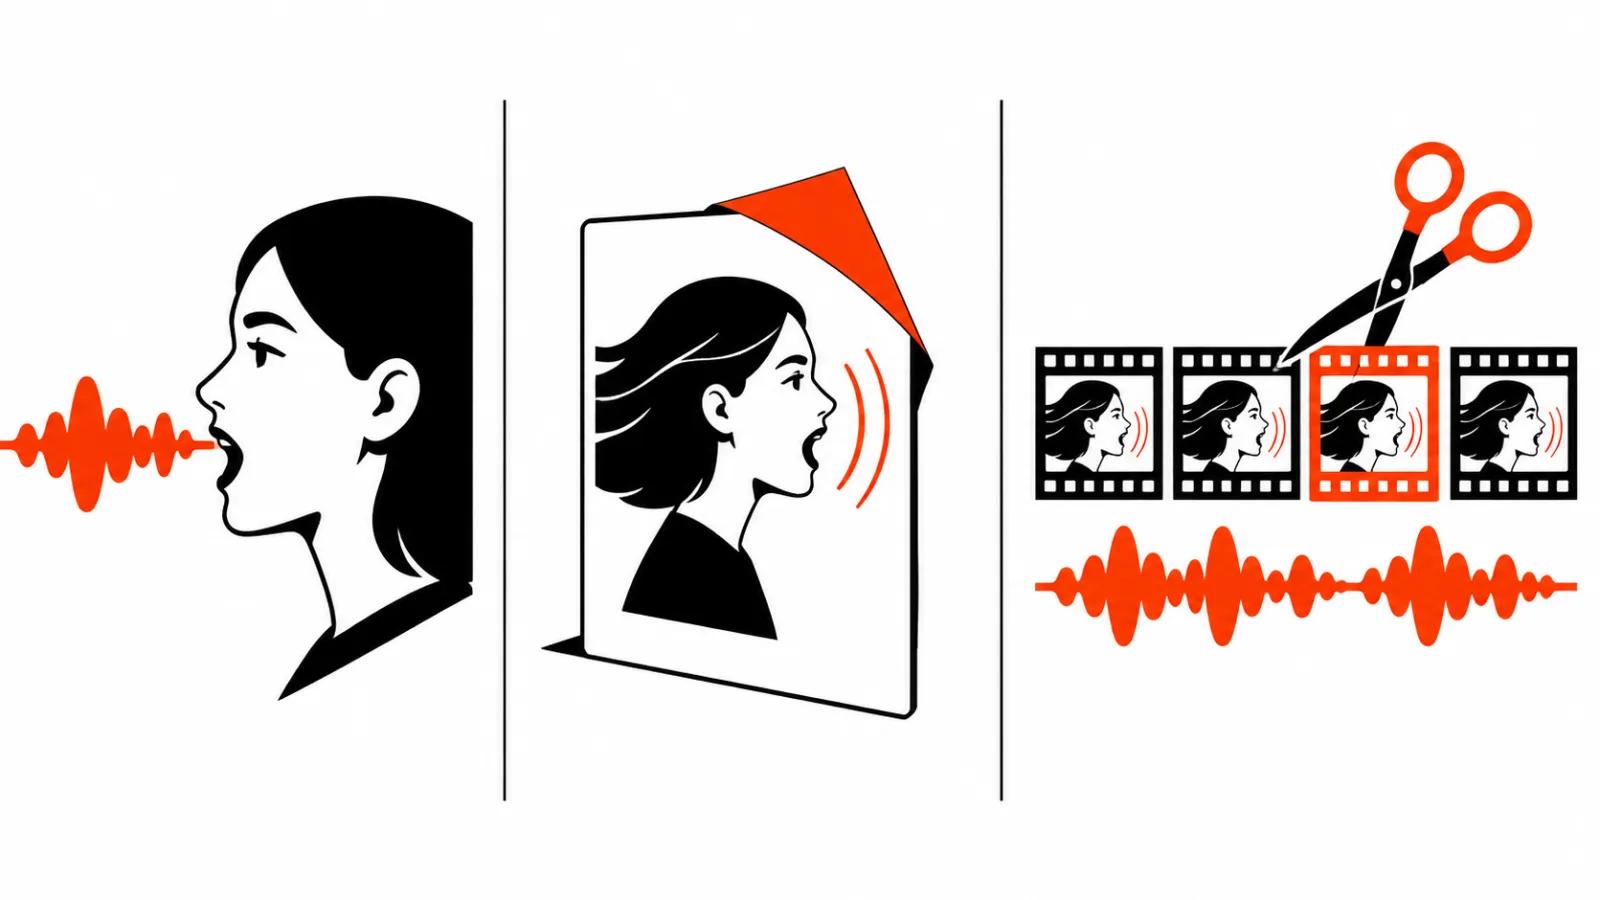
Первый путь: аватар под голос. Готовую дорожку подают на вход, сервис синхронизирует губы и мимику с речью. Подходит для объяснений, инструкций, новостей компании.
Второй: оживление одного фото. Из портрета делают говорящую голову, звук тот же. Дешевле съёмки, и не нужен человек в студии.
Третий: монтаж под озвучку. Кадры генерируют или берут из архива, а режут по речевым акцентам. Аватар не нужен, зато нужен монтажёр или хотя бы внятный тайминг.
| Путь | Что на входе | Где работает |
|---|---|---|
| Аватар | Запись плюс готовый образ | Инструкции, разборы, объявления |
| Фото | Один портрет плюс запись | Короткие ответы, поздравления |
| Монтаж под озвучку | Запись плюс кадры | Подкасты, лекции, интервью |
Что говорят официальные лимиты
В документации HeyGen для этого сценария указано прямо: свой аудиофайл, синхронизация с аватаром, цифровым двойником или любым изображением одного человека.
Форматы входа: MP3 или WAV, файл до тридцати двух мегабайт. Один запрос отдаёт до тридцати минут записи, и длина ролика равна длине аудио.
Запись длиннее тридцати минут режут на сегменты, по одному на запрос. Это не придирка сервиса, это способ уложиться в память рендера.
Число тридцать минут стоит держать в голове при планировании. Часовой подкаст это два запроса минимум, и на стыке сегментов потом придётся сшивать кадр.
Подкаст: два голоса и паузы
Подкаст с ведущим и гостем почти всегда требует выбора. Аватар анимирует одного человека, второй остаётся за кадром.
На практике это выглядит так: реплики ведущего закрывают аватаром, реплики гостя подписями и перебивками. Или наоборот, если лицо гостя узнаваемее.
Паузы и перебивания синхрон ломают охотнее всего. Сервис ставит движение губ по дорожке, и там, где двое говорят разом, получается шевеление без смысла.
Хороший приём: почистить дорожку до рендера. Убрать вдохи, выровнять громкость, разрезать наложение. Это скучная работа, и она экономит больше времени, чем повторный рендер.
Голосовое сообщение и лекция
Голосовое на две минуты это самый недооценённый исходник. Из него получается короткий ответ на частый вопрос клиента, и снимать ничего не нужно.
Лекция на час упирается в лимит сегментов и в монотонность. Один говорящий человек на экране сорок минут не держит внимание, поэтому лекцию режут на смысловые блоки и между ними ставят схемы.
Для лекций работает ещё один вариант: голос оставить, кадр собрать из слайдов и графики. Аватар тут не обязателен, и зритель не отвлекается на лицо.
Массовые вертикальные ролики из подкаста делают по тому же принципу: один вопрос, один короткий ответ, субтитры крупно. Запись служит сценарием, картинка вторична.
У длинной лекции я сначала собираю карту тем: пять или шесть вопросов, которые в ней разобраны. Каждый блок получает свой заголовок и отдельный ролик. Так из одной записи выходит серия, и её можно ставить по расписанию.
Где ломается синхрон
Первое место: быстрая речь. На скорости выше привычной модели не хватает кадров, и губы начинают отставать на слог.
Второе: согласные без гласных. Взрывные звуки вроде «п» и «б» требуют точной артикуляции, и на крупном плане это видно.
Третье: профиль и поворот головы. Анфас синхронизируется лучше, чем три четверти, и совсем плохо дело в профиле.
Четвёртое: музыка под речью. Если трек громкий, сервис может принять его за голос и начать артикулировать под ритм.
Пятое: несколько лиц в кадре. Алгоритм выбирает главное лицо, и в групповом кадре выбор может оказаться не тем, что вы задумали. Спасает крупный план одного человека и спокойный фон.
Шестое: слишком короткие реплики. На одном слове модель не успевает разогнать артикуляцию, и получается рывок. Такие вставки лучше вырезать заранее.
Что проверить до рендера
Дорожка: один голос, ровная громкость, без клиппинга, тишина в начале не больше половины секунды.
Текст: расшифровка совпадает с речью, имена и числа записаны так, как их надо показывать.
Кадр: лицо целиком, глаза открыты, фон спокойный, свет ровный. Для фото хватает портрета в анфас при хорошем освещении.
Права: на голос, на музыку, на изображение человека. Согласие на использование записи стоит получить до загрузки.
И проверка на телефоне: включите звук и посмотрите первые пять секунд. Если губы и речь расходятся уже там, дальше смотреть никто не станет.
Что в итоге
Видео из аудио это сборка вокруг уже существующей речи. Чем чище дорожка, тем меньше работы у модели и тем меньше поводов переделывать.
Мой порядок такой: расшифровка, чистка звука, нарезка по смысловым блокам, и только потом выбор между аватаром, фото и монтажом под озвучку.
Так подкаст, который лежал в архиве, превращается в серию коротких ответов. Видео нейросетями здесь закрывает рутину, а ручные ролики остаются для тех случаев, где нужна живая реакция в кадре.