Что анонсировала Facy.ai
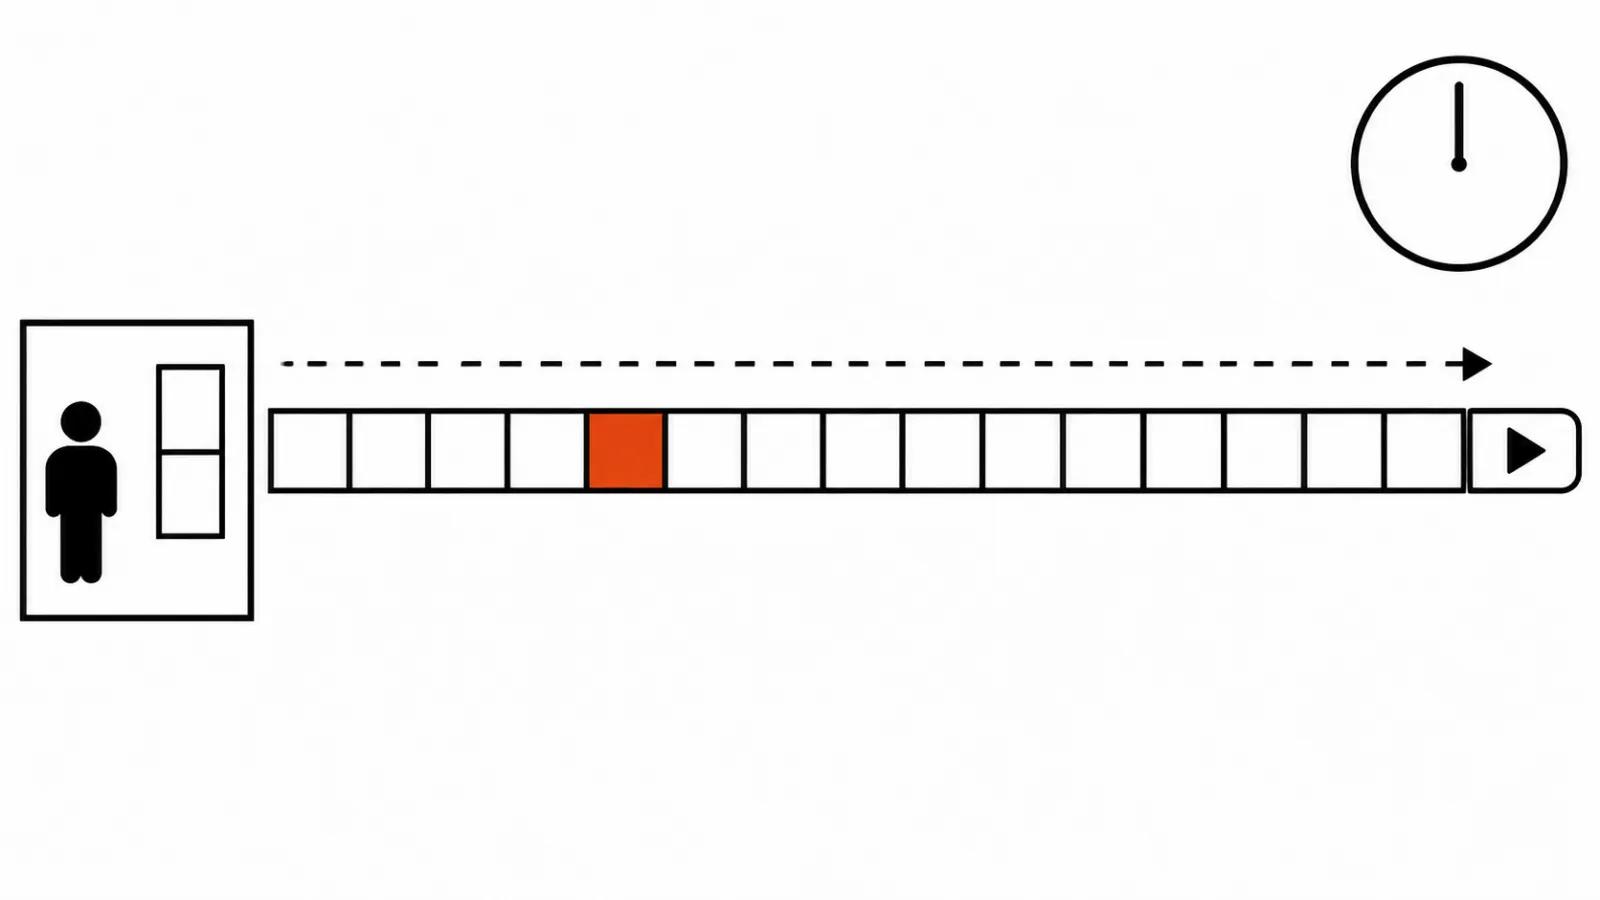
16 ноября Facy.ai сообщила, что готовится запустить Image-to-Video Long. Это платная функция для подписчиков: на входе одна картинка, на выходе ролик длиной до 15 секунд, разрешение 720p или 1080p на выбор. В релизе нет трёх вещей, которые обычно решают судьбу инструмента: какая модель считает кадры, сколько стоит прогон и когда кнопка появится в аккаунте. Дальше разговор про механику, которую компания описала сама.
Видео из одной картинки: зачем 15 секунд вместо 5
По словам компании, типичный короткий ролик длится около 5 секунд, а длинная сцена лучше передаёт настроение, действие и развитие. Оценка выглядит здраво. Пять секунд вмещают одну мысль: поворот головы, шаг, взгляд. Пятнадцать секунд вмещают три события, и из них складывается мини-история, где зритель успевает что-то почувствовать.
Моя позиция: длина сама по себе ничего не даёт. Пятнадцать секунд уместны там, где в кадре есть развитие, и вредят там, где движения нет. Одуванчик, который качается на ветру, растянется на пятнадцать секунд в скуку. Человек, который поднимает глаза от телефона, узнаёт кого-то и улыбается, на такой длине работает.
Отдельная сложность: вход один, картинка. Всё движение модель придумывает от себя, а чем дольше оно идёт, тем больше шансов, что подведёт фон, одежда или лицо. Длинная сцена из одного стоп-кадра это компромисс, и держать его лучше на простых сценах.
Как оживить фото нейросетью: два способа промпта
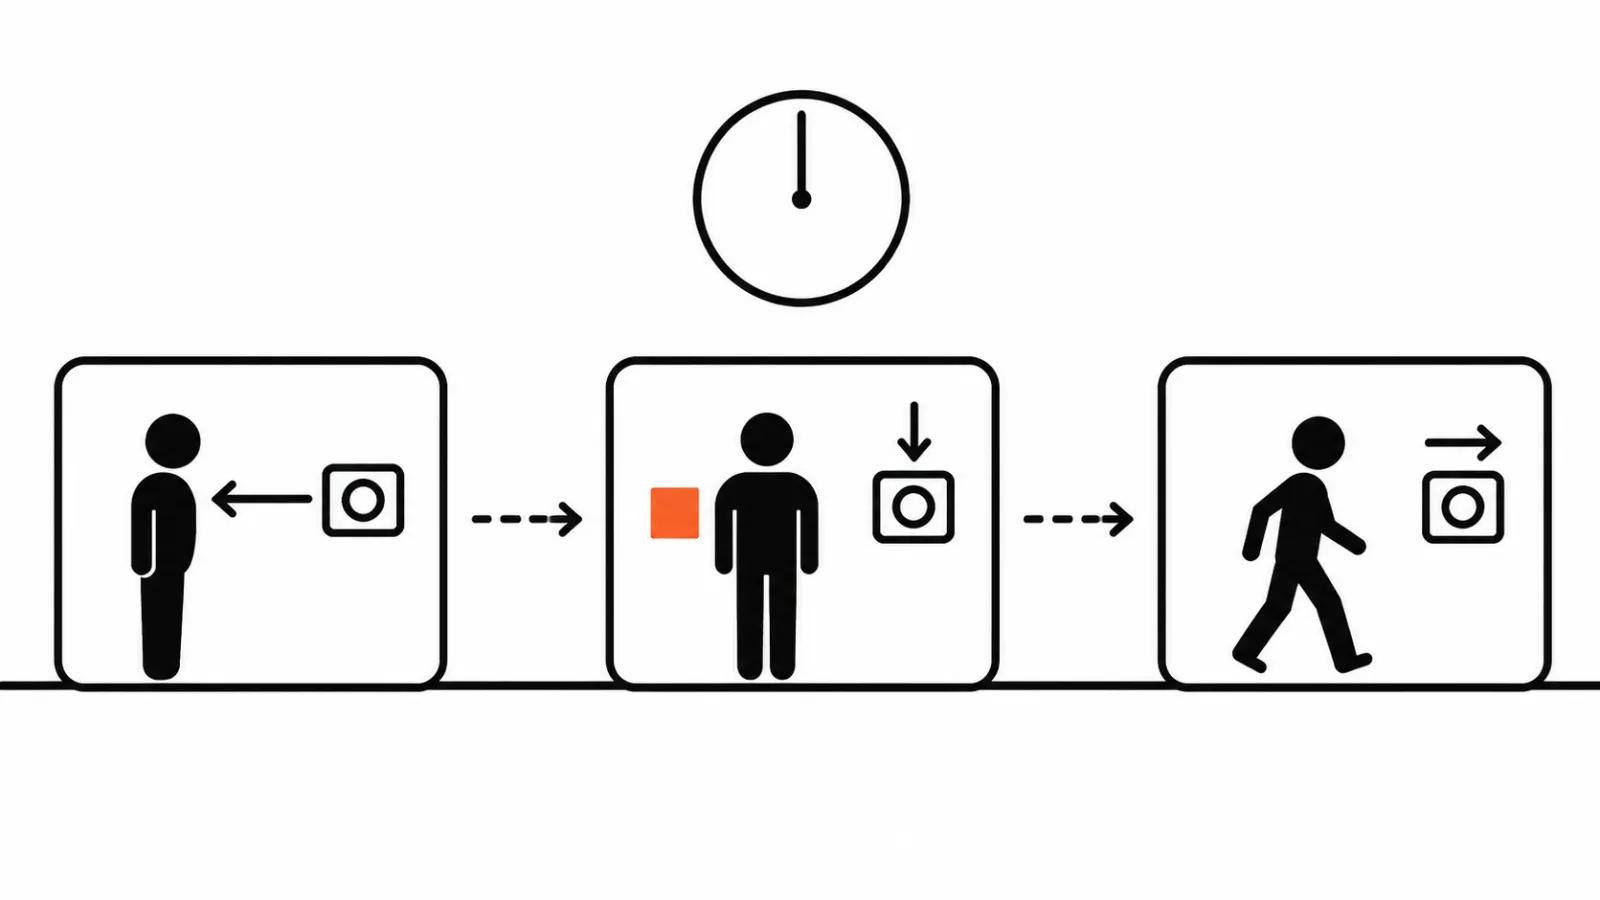
Сервис обещает два режима. Первый это один общий текст на весь ролик: что в кадре, кто герой, что происходит. Второй это несколько пошаговых промптов, каждый описывает свой кусок: начало, середину, финал. Рядом стоит Prompt Expander, который по желанию улучшает любой из вариантов, общий и пошаговый.
Выбор зависит от задачи. Общий текст хорош, когда весь ролик это одно движение: наезд камеры, поворот предмета, падающий снег. Пошаговый нужен, когда события сменяют друг друга, потому что одно предложение на три события модель часто выполняет только первым.
Как писать пошаговый промпт: три вещи на каждый шаг
В каждом шаге отвечаю на три вопроса. Что делает герой. Что делает камера. Примерно когда это происходит.
Пример на три шага, героиня у окна. Шаг первый, начало ролика: она стоит у окна, смотрит в сторону улицы, камера медленно приближается. Шаг второй, середина: героиня поворачивает голову к камере и улыбается, камера останавливается. Шаг третий, финал: она отходит от окна, камера остаётся на месте.
Три правила, которые следуют из описания сервиса. Камере даю одно движение на шаг, потому что два движения в одном шаге модель почти всегда смешивает. Время пишу словами, начало, середина, финал, поскольку точных тайм-кодов сервис не обещал и придумывать их в промпте бессмысленно. Шагов делаю не больше трёх, потому что на четвёртом начинаются стыки.
Prompt Expander помогает, когда промпт написан наспех, и мешает, когда в нём уже есть конкретика. Он переписывает текст своими словами и может сгладить деталь, за которую вы держались. После расширения я перечитываю результат и возвращаю то, что пропало.
Где пошаговый промпт ломается
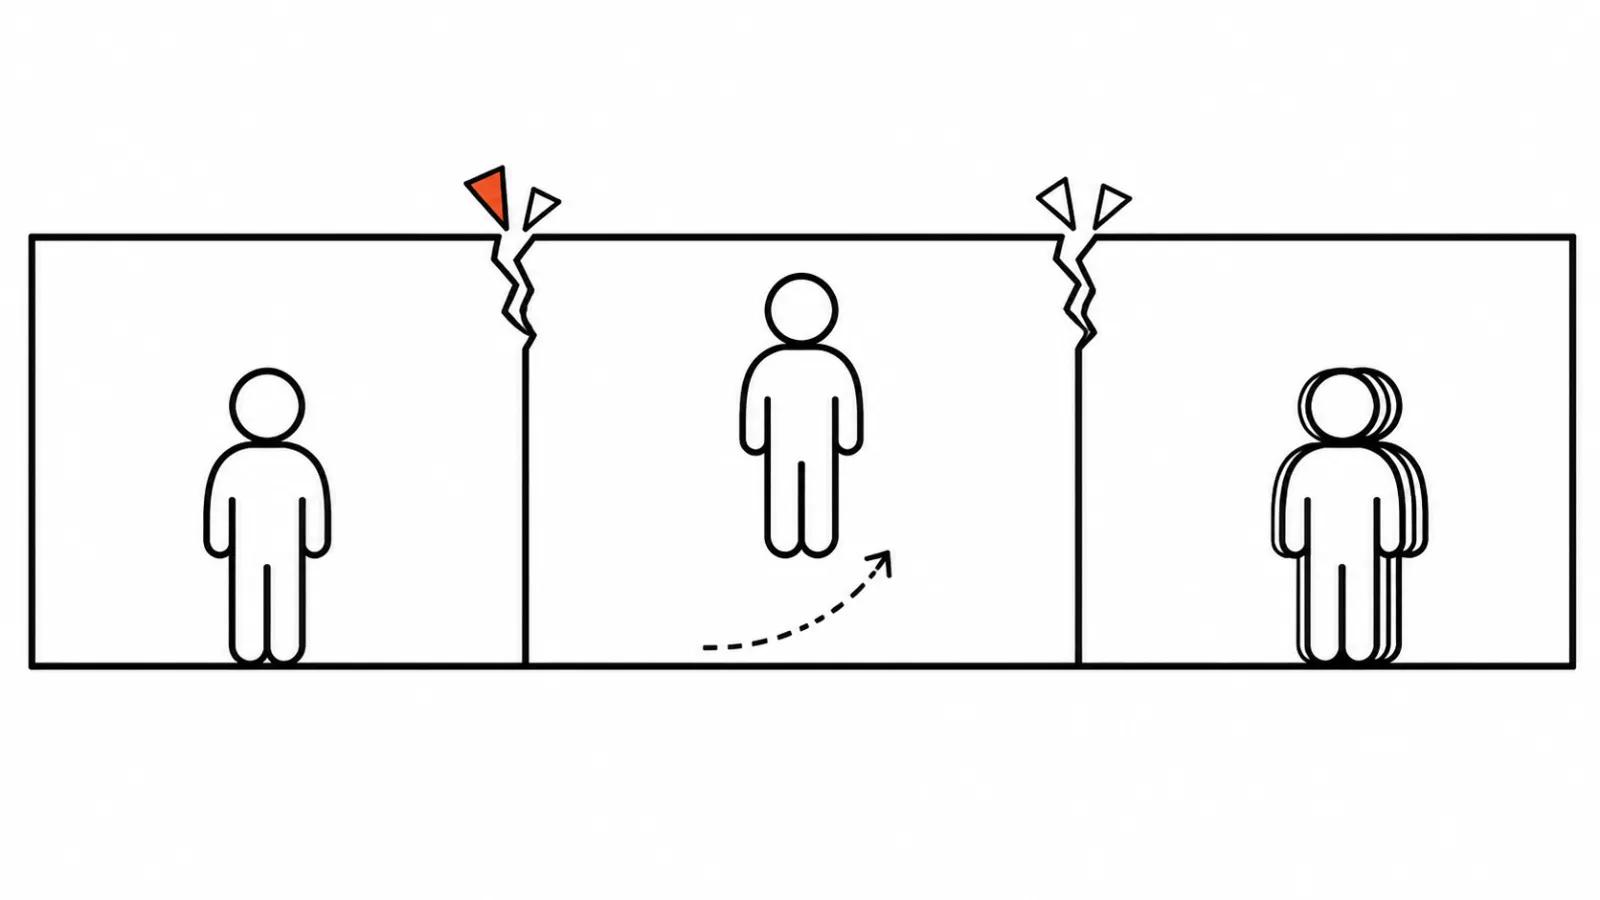
Первый риск это стык. Между шагами модель не помнит предыдущий кадр так же точно, как внутри шага, поэтому поза героя может прыгнуть, а свет измениться. Чем ближе шаги по композиции, тем стык незаметнее.
Второй риск это лицо и руки к концу длинной сцены. На пятой-десятой секунде мелкая моторика начинает плыть, и на крупном плане это видно сразу.
Третий риск это фон. Движущаяся камера вскрывает то, что за героем было нарисовано на картинке: текстура ползёт, дальний план теряет форму, отражения едут.
Совет из этого простой. Если в исходной картинке сложный фон, длинную сцену лучше не заказывать. Короткая ошибка стоит дешевле длинной, и переделывать пятнадцать секунд дороже, чем пять.
Что это меняет в заказе
Для рекламы пятнадцать секунд из фото это удобный формат: вертикальная реклама живёт в ленте кадрами по пять-пятнадцать секунд, и такой ролик закрывает целый слот без съёмки. Подходит для товара, который уже снят: упаковка на столе, кроссовок на полке, интерьер с нужным светом.
В производстве видео нейросетями такая функция встаёт в начало цепочки: оживить картинку, отобрать движение, дальше собрать версии под площадки. Если интересно, что происходит внутри, у нас есть разбор, как картинка превращается в видео.
Ограничение, о котором стоит сказать заказчику заранее. Раз цены и даты запуска нет, считать смету по этому инструменту нельзя. Известны только 720p и 1080p, а младшее разрешение в ленте на телефоне иногда выглядит мягко, особенно на тексте и мелких деталях.
Мой вывод
Image-to-Video Long решает понятную задачу: превратить один хороший кадр в пятнадцать секунд движения. Ценность тут в другом. Пошаговый промпт заставляет заранее придумать, что происходит в ролике, и пока человек пишет три шага, он понимает, есть ли в сцене развитие. Часто выясняется, что развития нет, и тогда хватает пяти секунд.
Что я буду проверять на первом же доступе: держится ли лицо к концу сцены, сшиваются ли шаги без прыжка, слушается ли камера. Ответы на эти три вопроса важнее списка разрешений.